Lo que ves arriba en el reel no es una segunda cámara: es la misma toma,
reencuadrada por un modelo que salió hace ocho días. Aquí está qué modelo es, cuál de sus
endpoints hace eso, qué se sube exactamente, cómo se escribe el prompt, lo que cuesta de
verdad — y los cinco errores que te van a cobrar en la primera tarde.
Referencias en una pasada: 30 imágenes + 10 videos + 10 audios
720p
El techo real de la API — a 24 fps
$0.28
Por segundo, con video de referencia a 720p
¿Sin ganas de tocar una API? El mismo modelo vive
dentro de Dreamina,
el producto de ByteDance — la lógica de esta guía es idéntica, sólo cambia dónde subes los
archivos.
Límites, parámetros y precios consultados en el blog de ByteDance Seed y en fal.ai el
8 de agosto de 2026, ocho días después del lanzamiento. Todo esto es material nuevo y
puede cambiar; cada captura lleva su fecha.
La guía en cinco líneas
→ No es un recorte del video: es una generación nueva que usa tu toma como
referencia.
→ Se hace en el endpoint reference-to-video, el único que acepta un video de entrada.
→ Tu toma se sube troceada a 30 segundos o menos, más 2–4 fotos sueltas de tu cara.
→ El ángulo se escribe en el prompt — no hay perilla de cámara: «low angle, slow
push-in, handheld drift».
→ Apaga generate_audio o el modelo te reinventa la voz. Y cuesta
~$0.28 USD por segundo, contando también los segundos que subes.
01 — Qué es
El modelo salió el 31 de julio, y lo que cambió no es la calidad: es que ya acepta tu material
Seedance 2.5 es el modelo de generación de video de ByteDance Seed — la misma
casa de TikTok y CapCut. ByteDance saltó de la versión 2.0 directo a la 2.5: no existen 2.1 a
2.4. Se lanzó primero dentro de sus propios productos (Jimeng y Doubao) y la API pública para
desarrolladores llegó una semana después.
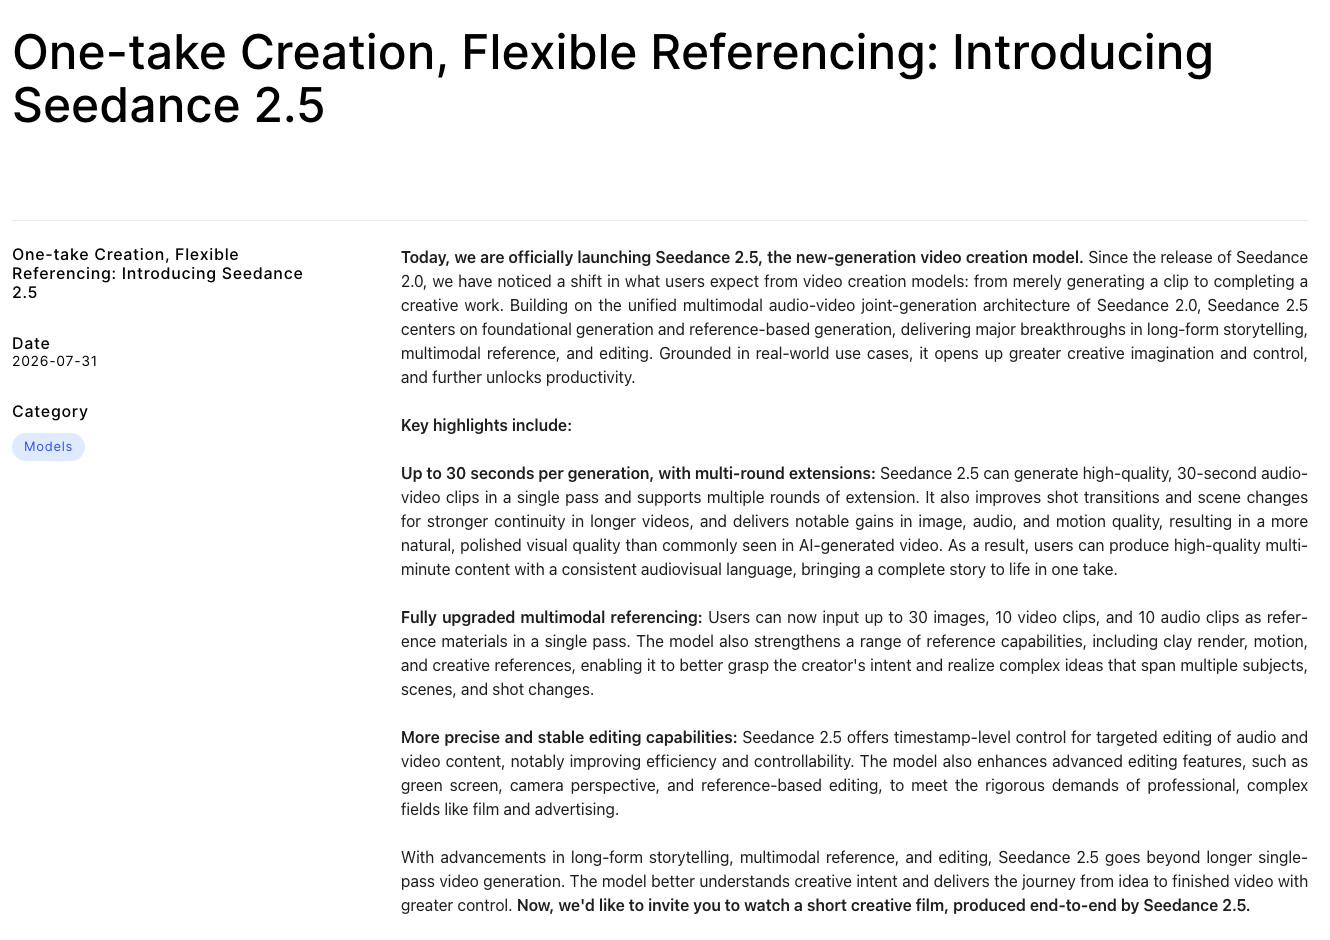
El titular de su anuncio dice exactamente de qué va la versión — y no habla de píxeles:
“One-take Creation, Flexible Referencing”
Creación en una sola toma, referenciado flexible. Traducido a lo que te importa:
el modelo dejó de ser una máquina de generar clips de la nada y se volvió una máquina que
toma tu material como punto de partida — tu video, tus fotos, tu audio — y trabaja
sobre él.
seed.bytedance.com · anuncio oficial · 31 jul 2026
Los dos párrafos que sostienen todo lo demás, textuales de ese anuncio:
“Up to 30 seconds per generation, with multi-round extensions.”
Hasta 30 segundos por generación, con rondas de extensión. Ése es el bloque con
el que vas a trabajar: 30 segundos, ni uno más por tirada.
seed.bytedance.com · 31 jul 2026
“Users can now input up to 30 images, 10 video clips, and 10 audio clips as reference materials in a single pass.”
Hasta 30 imágenes, 10 clips de video y 10 de audio como referencia en una sola
pasada — 50 entradas en total. Aquí es donde cabe tu toma.
seed.bytedance.com · 31 jul 2026
seed.bytedance.com — anuncio de Seedance 2.5
El anuncio, sin retoque. Fecha visible: 2026-07-31. Los tres puntos
destacados son los que se citan arriba. Captura del 8 ago 2026.
Por qué esto te importa aunque nunca lo abras
La diferencia entre “generar un video con IA” y “darle tu video a una IA para que lo
reencuadre” es la diferencia entre un resultado que no controlas y uno que sí. Grabas una vez,
con la cámara donde puedas ponerla, y los ángulos se deciden después. Eso mueve el
cuello de botella de la producción a la edición — que es exactamente donde una persona sola
puede competir con un equipo.
02 — Dónde vive
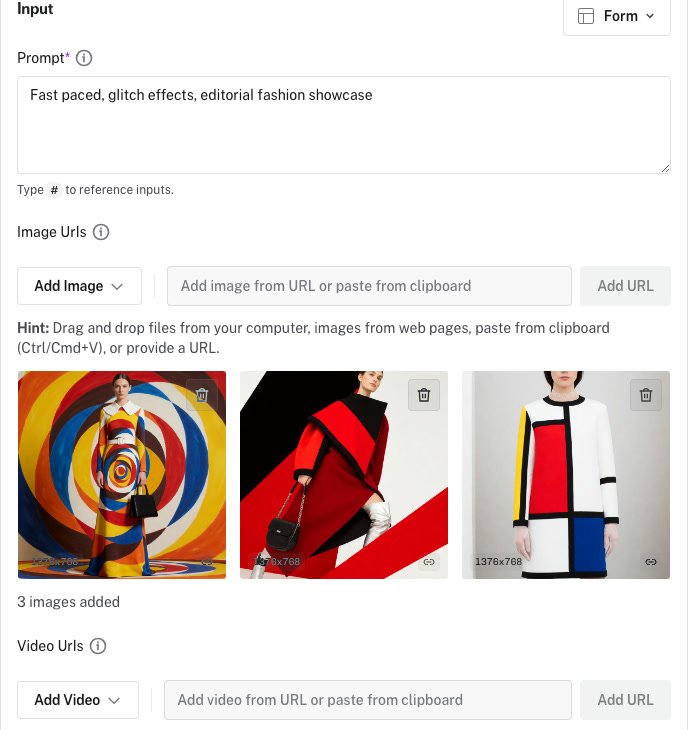
La función se llama Flexible Referencing y el endpoint que la hace es reference-to-video
Seedance 2.5 tiene tres endpoints públicos en fal.ai, y sólo uno sirve para esto:
text-to-video genera desde cero. image-to-video anima una imagen (y acepta un
frame final, que es el clásico “primer y último cuadro”). Y
reference-to-video es el único que acepta un video como
referencia — el tuyo. Ése es el que reencuadra una toma que ya existe.
Dentro del prompt, cada cosa que subes se invoca con una etiqueta numerada según el orden
en que la subiste: @Video1, @Image1, @Image2,
@Audio1. La documentación de Replicate usa corchetes —
[Video1] — para lo mismo.
El panel real. Arriba el prompt; debajo Image Urls y
Video Urls. Ahí van tus frames y tu clip. Captura del 8 ago 2026, sin retoque.
Y éstos son los límites reales de lo que puedes subir. Vale la pena leerlos antes de
cortar nada, porque tres de ellos deciden cómo tienes que preparar el material:
1Duración del clipEntre 1.8 y 30.2 segundos por archivo, y la suma de todos tus videos no puede pasar de 30.2 s.
2Peso y formatoMP4 o MOV, máximo 200 MB por video. Las imágenes: JPG, PNG, WebP y varios más, hasta 30 MB cada una.
3Tamaño del cuadroEntre 300 y 6000 px por lado, con relación de aspecto entre 0.4 y 2.5. Un vertical 9:16 (0.5625) entra.
4Fotogramas de entradaDe 24 a 60 fps. Lo que salga, en cambio, sale siempre a 24.
5Cuántas cosasHasta 30 imágenes + 10 videos + 10 audios, y como mucho 50 archivos entre todos.
6AudioMP3 o WAV, 1.8–30.2 s, máx. 15 MB. Y exige que haya al menos una imagen o video acompañándolo.
La toma del reel duraba 29 segundos. Cabía por un pelo.
Los 30.2 segundos no son una recomendación: es un tope duro y es la suma de todos
los videos que subas. Si tu toma dura más —y casi cualquier talking-head real dura más— el
primer paso del workflow no es escribir el prompt: es partir el clip. Es la restricción
que más planes rompe, y no aparece en ningún tutorial de portada.
03 — La letra chica
Lo que cuesta, y el 4K que te están vendiendo y no existe
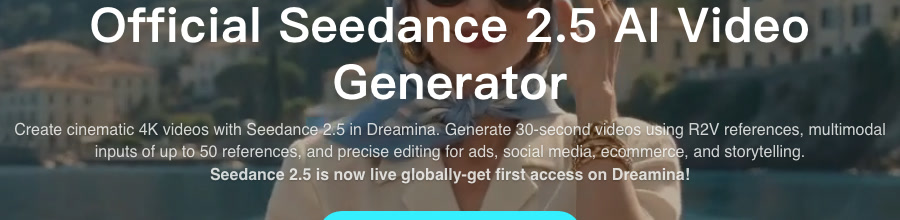
“Genera video 4K cinematográfico”Eso dice la página de Dreamina, que es de ByteDance. Pero el
modelo que llegó a la API sólo expone 480p y 720p, a 24 fps. En vertical, 720p
significa 720×1280. No hay un parámetro de 4K que activar: no está.dreamina.capcut.com/seedance/seedance-2-5 vs. fal.ai · 8 ago 2026
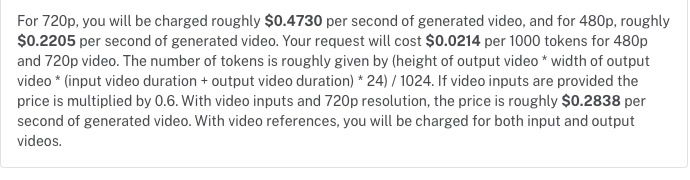
“¿Y cuánto me va a costar?”A 720p son $0.4730 USD por segundo generado. Pero cuando metes un
video de referencia el precio se multiplica por 0.6, y queda en
$0.2838 por segundo. Traducido: 30 segundos reencuadrados ≈ $8.5 USD por
tirada. Y las tiradas nunca son una.fal.ai · página del modelo · 8 ago 2026
dreamina.capcut.com — página oficial de Seedance 2.5
El 4K, en su propia página. “Create cinematic 4K videos with
Seedance 2.5”. La API pública no ofrece más de 720p. Captura del 8 ago 2026.
fal.ai — el precio, tal cual lo escribe
El precio, sin traducir. Ahí están las cuatro cifras y la fórmula
completa. Captura del 8 ago 2026.
Lo que pides
Segundos que te cobran
Costo
Un ángulo: subes 10 s, pides 10 s · 720p
20 s (entrada + salida)
≈ $5.68
Cuatro ángulos del mismo trozo · 720p
80 s
≈ $22.70
Un clip completo: subes 30 s, pides 30 s · 720p
60 s
≈ $17.03
La misma prueba de un ángulo · 480p
20 s
≈ $4.41
Encuentra el prompt en 480p. Tira el bueno en 720p.
Esa última fila es el consejo que más dinero ahorra: las primeras cinco o seis tiradas
son para descubrir qué palabras mueven la cámara, y para eso la resolución da igual.
Cuando el encuadre ya sale como lo quieres, cambias una línea y tiras el bueno. Quienes lo
usan a diario van más lejos todavía: prueban en Seedance 2.0, que es ~50% más barato,
y sólo pagan 2.5 en el render final.
La trampa de la fórmula
Lee otra vez la última línea de esa captura: “With video references, you will be charged
for both input and output videos.” El cálculo suma la duración del video que
subes a la del que sale. Si mandas 29 segundos de referencia para pedir 10 de
salida, pagas 39. Súbelo recortado a lo que de verdad necesitas.
04 — El workflow
Seis pasos para convertir una toma fija en otro ángulo
Éste es el camino completo. No hay que programar nada: los tres primeros pasos son ffmpeg
o cualquier editor, y el resto se hace en el panel que viste en la sección 02.
1Corta la toma en trozos de 30 segundos o menostope duro · 30.2 s sumando todos los clips
Cada trozo es una generación aparte. Corta en pausas naturales del habla, no a mitad de
una palabra: el modelo va a re-sintetizar el movimiento y una frase partida se nota.
2Saca 2–4 fotogramas limpios de ti — sueltos, nunca en collagecara de frente · perfil · plano medio con la ropa
Son las imágenes que le dicen al modelo cómo eres. Van como archivos separados, uno por
encuadre.
Esto ahorra dineroMeter varios encuadres dentro
de una sola imagen tipo collage o cuadrícula da peores resultados que subirlos por
separado. Cada referencia debe enseñar una cosa.
3Sube el clip en Video Urls y los fotogramas en Image Urlsel clip queda como @Video1 · los frames como @Image1, @Image2…
La numeración de las etiquetas sigue el orden de subida dentro de cada tipo. Si
te equivocas de orden, el prompt va a estar hablando de la imagen equivocada.
4Escribe el prompt con el patrón “cambia esto, conserva el movimiento”estructura: sujeto → acción → cámara → estilo
La sección 05 trae los prompts listos para copiar y el vocabulario de cámara que el
modelo entiende.
5Apaga la generación de audiogenerate_audio: false
Viene encendida por defecto y el modelo reinventa la voz a partir de lo que
deduce de tus imágenes. Si vas a conservar tu audio original —y en un talking-head siempre
es que sí— este interruptor no es opcional.
Lo que pasa si noEn una prueba documentada, el
modelo le puso a un personaje una voz que no correspondía en absoluto. No es un error que
puedas arreglar después: hay que volver a pagar la tirada.
6Fija resolución, aspecto, duración y semilla720p · 9:16 · 4–30 s · seed fijo
La semilla es lo que te deja repetir la misma tirada cambiando una sola palabra
del prompt. Sin ella cada intento es un experimento nuevo y no aprendes nada de la
comparación.
720p en 9:16 sale a 720×1280. Es menos de lo que grabaste, así
que este material va como capa dentro de un montaje, no como el master. En el reel que trajo
aquí, el reencuadre vive dentro de un cuadro de 1000 px de ancho: a ese tamaño no se nota.
05 — El prompt
Cuatro bloques en orden, y un vocabulario de cámara que el modelo sí entiende
La estructura que recomienda la propia guía de ByteDance es siempre la misma:
sujeto → acción → cámara → estilo. Y hay una lista corta de movimientos que el modelo
reconoce por su nombre. Escribirlos así vale más que describirlos con adjetivos:
1push-inLa cámara se acerca de frente, sin cortar. Es el que más se siente en un talking-head.
2dolly (left / right)Desplazamiento lateral limpio, como sobre rieles.
3orbitGira alrededor del sujeto manteniéndolo al centro.
4handheld driftMicro-movimiento de cámara en mano. Es lo que hace que no parezca un render.
5trackingSigue al sujeto conservando el encuadre.
6macro detail shotEl plano cerradísimo. Úsalo una vez por pieza o pierde el efecto.
El patrón base para reencuadrar es “cambia X, conserva el movimiento original”. Éste
es el ejemplo textual que publica la documentación de Replicate — cámbiale el sujeto y ya
tienes el tuyo:
“Replace the perfume in [Video1] with the face cream from [Image1], keeping the original camera movement and lighting.”
Sustituye el perfume de [Video1] por la crema de [Image1], conservando el
movimiento de cámara y la iluminación originales. Esa segunda mitad de la frase es la que
hace todo el trabajo.
replicate.com/bytedance/seedance-2.5 · 8 ago 2026
receta 1 — un solo ángulo nuevo
Keep the person, the room and the timing from @Video1 exactly as they are.
The face and clothing match @Image1 and @Image2.
Re-frame the same moment as a slow push-in from a low angle, ending at
a medium close-up. Handheld drift, very subtle. Natural daylight, no
color grade, no added text. Do not use the background from @Image1.
Todo lo que no quieres que cambie se nombra explícitamente. El
modelo interpreta el silencio como permiso.
receta 2 — varios ángulos dentro del mismo clip
Same person, same room, same audio timing as @Video1.
Face reference: @Image1, @Image2.

0-4s   wide shot from the side, static.
4-9s   cut to a top-down angle looking down at the desk.
9-15s  cut to a medium close-up, slow push-in, handheld drift.

Keep the subject consistent across all three shots. Natural daylight.
El anuncio oficial confirma el control por marcas de tiempo y que
el modelo mantiene al sujeto estable entre cortes dentro de una misma generación. Es la forma
barata de sacar tres ángulos: una tirada en vez de tres.
receta 3 — el prompt del reel (el que uso yo)
Create a 28.6-second Seedance 2.5 video-to-video transformation using the uploaded footage as the exact performance reference.

Preserve the same room, chair, microphone, clothing, hair, body proportions, facial identity, skin texture, hand gestures, eyeline, lip movement, speech timing and acting. He wears no cap and no hat. He holds a small handheld microphone in his right hand the whole time. The main character's face must remain identical in every frame. Do not beautify, reshape, replace or reinterpret him. Keep every spoken word unchanged with accurate lip sync.

Make it one continuous, dynamic music-video-style take inside the same room. No cuts, scene changes, teleporting, duplicate characters or random objects. Every virtual camera move must connect smoothly with believable perspective, parallax, motion blur and room geometry. Keep the character anchored to his original performance. Do not distort or cover his face. Use polished kinetic supers timed to key phrases, appearing beside or behind him with realistic depth and clean dissolves. Do not subtitle the spoken words — the only on-screen text is the supers listed below, exactly as written.

0-2.65s, "¿Sabías que puedes lograr estas tomas cinematográficas"
Start from the original framing. The daylight and the room lights power off, turning the room dark and creating a dramatic stage silhouette with a thin rim light around his hair and shoulders, subtle haze and a back spotlight. Add a slight floating camera push. Large 3D text "TOMAS DE CINE" briefly forms behind him, partially hidden by his body, then fades. Preserve enough facial detail to maintain identity.

2.65-4.3s, "sin tener que mover tu cámara?"
Accelerate smoothly into a tight face close-up using a physical camera push, not a digital crop. Keep his face sharp and unchanged. "¿SIN MOVER LA CÁMARA?" appears briefly beside him without blocking his face.

4.3-8.2s, "Simplemente tienes que grabarte sentado y completamente quieto con tu tripié"
Normal daylight returns. Pull rapidly backward beyond the original framing and extend the same room naturally, revealing a smartphone on a tripod in the foreground recording him. Correct perspective must show this was a locked static setup. Add "TOMA ESTÁTICA" near the tripod. Do not duplicate the character.

8.2-11.5s, "Pasar esa toma estática a Seedance 2.5"
Lower the virtual camera toward desk height and arc smoothly to one side, ending on a strong side-profile angle. Keep his performance and lip sync exact from the new perspective. "SEEDANCE 2.5" travels through the room with dimensional depth, then dissolves.

11.5-15s, "y describirle ahí el ángulo de la cámara o el movimiento que quieras"
A translucent holographic interface appears beside him. "TOP DOWN" types itself into the interface, glows, then dissolves as the command activates. The camera cranes vertically upward into a high top-down angle while he continues speaking and looks naturally toward the moving camera. Preserve the room layout and avoid ceiling or body warping.

15-18s, "Puede ser algo suave como un gimbal acercándose"
Descend to eye level and perform a clean gimbal move: smooth push toward him, ease backward, then settle. No jerky digital zoom. "GIMBAL SUAVE" passes behind his shoulders.

18-21s, "o algo más agresivo como un dron dando la vuelta alrededor"
Accelerate into one complete 360-degree indoor drone orbit around him. Keep him fixed in the chair and the room consistent. Use believable motion blur and near-object parallax, then land precisely at the original frontal position. No cloning, room mutation or lip-sync interruption.

21-24.6s, "¿O hasta títulos 3D gigantes apareciendo detrás de ti?"
Kinetic 3D words appear behind him in sequence: "3D", "GIGANTE", "DETRÁS DE TI". The letters occupy real space, cast subtle light and shadow, and are correctly hidden where his body overlaps them. They pop outward with impact, then retract and dissolve.

24.6-28.6s, "Te lo juro, nunca vas a tener que contratar un camarógrafo, nunca más."
A cameraman enters naturally from the right side carrying a compact camera rig. Without stopping his speech or changing his eyeline, the main character firmly but playfully pushes and signals him out with his free left hand. The cameraman reacts and exits. "SIN CAMARÓGRAFO" appears behind them, then disappears. Return to the original framing.
Éste es el prompt real que uso yo, marca de tiempo por marca de tiempo —
no el patrón genérico de la documentación. Nota dos cosas que hace distinto de las recetas 1 y
2: primero, cada bloque de tiempo trae su propia línea de guion pegada, así el modelo
sabe exactamente qué se está diciendo mientras cambia el ángulo — el prompt entero es, en el
fondo, un guion con dirección de cámara encima. Segundo, el prompt describe el gesto físico
de sacar al camarógrafo (24.6-28.6s) en vez de solo pedir "sin camarógrafo": ese nivel de
detalle en la acción es lo que evita que Seedance invente algo raro con las manos.
Lo que acota el prompt es tan importante como lo que pide
La regla que más repiten quienes ya lo usan: decir qué se toma de cada referencia y qué
no. “@Image1 define la cara y el peinado, nada más” evita que el modelo te copie también
el fondo, la luz o la ropa de esa foto. Y al revés: cuanto más se llena el prompt de acciones
concretas, más sube la probabilidad de error. Pide una cosa por tirada.
06 — Los errores
Cinco cosas que te van a cobrar en la primera tarde
1Dejar el audio encendidoViene en true por defecto y el modelo inventa una voz. Se paga la tirada completa para descubrirlo.
2Subir los ángulos en un collageUna imagen con cuatro encuadres rinde peor que cuatro imágenes. Cada referencia enseña una sola cosa.
3Pedirle cinco cosas a la vezLa probabilidad de error sube con cada acción concreta que metes. Una petición por tirada, y encadena.
4No fijar la semillaSin seed fijo, cambiar una palabra te da un video distinto por razones que no controlas. No aprendes nada comparando.
5Hacer las pruebas en 2.5Es ~50% más caro que 2.0 en la API oficial. Quienes lo usan a diario prueban el encuadre en 2.0 y reservan 2.5 para el render final.
Y revísalo cuadro por cuadro
ByteDance reconoce en su propio anuncio que la plausibilidad física de los movimientos
complejos y la estabilidad de las escenas con varios sujetos siguen sin resolverse. Los
fallos documentados —deformaciones del personaje en movimiento rápido, objetos con la escala
disparatada— no se ven a velocidad normal. Se ven parando el video.
07 — El filtro
Para quién sí, para quién todavía no
Te conviene si…
Grabas talking-head a una sola cámara y te falta variedad de plano, no ideas.
Ya editas lo que grabas: esto es una capa dentro de un montaje, no un botón mágico.
Puedes presupuestar unos dólares por pieza y varias tiradas por cada acierto.
Tus clips caben o se pueden partir en bloques de 30 segundos.
Todavía no, si…
Necesitas 4K: hoy el techo real es 720p y no hay parámetro que lo suba.
Buscas lip sync perfecto sobre tu audio: la voz la regenera y hay que apagarla.
Publicas una vez al mes — el costo por pieza no se amortiza contra tan poco.
No tienes con qué revisar cuadro por cuadro. Los fallos no se ven a velocidad normal.
08 — Fuentes
De dónde salió cada cifra
El anuncio oficial de Seedance 2.5 — ByteDance Seedseed.bytedance.com — “One-take Creation, Flexible Referencing”Fecha del post: 31 jul 2026. De aquí salen los 30 s, las 50 referencias, el control por marcas de tiempo y la limitación reconocida de física · consultado 8 ago 2026
La sintaxis de referencias y el prompt de ejemploreplicate.com/bytedance/seedance-2.5El patrón “Replace … keeping the original camera movement” y la notación con corchetes · consultado 8 ago 2026
El vocabulario de cámara y la estructura del promptdreamina.capcut.com — guía de promptsProducto de ByteDance. Es también la página que anuncia el 4K que la API no tiene · consultado 8 ago 2026
El precio oficial en China y el salto respecto a 2.0news.qq.com — cobertura del lanzamiento42 y 70 yuanes por millón de tokens, con y sin video de entrada; 2.0 costaba 28 y 46 · 31 jul 2026
Nota de método
Las cuatro capturas son reales y sin retoque, tomadas el 8 de agosto de 2026: el
anuncio en el blog de ByteDance Seed, el panel de entrada y el párrafo de precios de fal.ai, y
la portada de Dreamina. El marco de navegador que las envuelve es un elemento de diseño de
esta guía. Hay tres cosas que no pudimos verificar y por eso no se afirman aquí:
(1) no existe documentación oficial de ByteDance para este caso exacto —subir una toma
de talking-head y sacar N ángulos—; lo que hay son las piezas (referenciado por video, control
de cámara, marcas de tiempo) y este workflow las junta. (2) No encontramos ningún
parámetro dedicado de control de cámara: todo se hace por prompt. (3) No hay prueba
publicada de qué tan idéntico se mantiene el rostro de una persona real al reencuadrar;
júzgalo con tu propia cara antes de confiarle una pieza de cliente. La contradicción del 4K
está documentada arriba con las dos capturas enfrentadas. Precios y límites pueden cambiar:
son de un modelo que tiene ocho días. Sotai no está afiliada a ByteDance, fal.ai ni
Replicate y no gana nada si los usas.
¿Y si esto no fuera un experimento, sino tu forma de producir?
Lo que acabas de leer es una herramienta suelta. Lo que de verdad cambia un negocio es el
sistema alrededor: que el material entre, se procese y salga publicado sin que alguien lo
empuje a mano. En Sotai armamos justo eso, a la medida — agentes y automatizaciones con tus
datos y tu forma de trabajar. Escríbenos y en cinco minutos te decimos si te conviene o si con
esta guía ya la hiciste.