 Sotai
Guía paso a paso · agosto 2026
Una toma fija,
una toma de cine
Te sientas frente a un celular en un tripié, no te mueves, y hablas treinta segundos. Todo lo demás —la luz que se apaga, las paredes que se abren, el dron que da la vuelta— lo pone Seedance 2.5 encima de esa misma toma. Aquí está el prompt completo que hizo el video, bloque por bloque y con el cuadro que produjo cada uno; las cuatro capas que lleva por dentro y por qué ninguna sobra; un catálogo de movimientos listos para pegar; lo que cuesta de verdad una tirada; y los cinco errores que se pagan a la primera tarde. No hay que programar nada.
Ir al prompt completo- 1toma, sin cortes y sin mover la cámara
- 10bloques de tiempo, uno por frase
- 28slo que dura lo que se generó
- $16lo que cuesta una tirada a 720p
Precios y parámetros consultados el 20 de agosto de 2026
Parte 01 · la decisión
Qué necesitas antes de escribir una sola línea
Esto no es un generador de video al que le pides una escena. Es un editor: le das una toma tuya y la reencuadra. De ahí sale la única regla que gobierna todo lo demás.
El modelo reencuadra lo que ya existe. No inventa lo que no grabaste. Si en tu toma no hay una lámpara, no puede encenderla de forma creíble. Si no hay cuarto detrás de ti, no puede abrirlo. Si te moviste, pelea contra tu movimiento. Por eso la mitad del trabajo está en la toma, no en el prompt.
Un celular y un tripié
Cualquier teléfono moderno sirve. El tripié no es opcional: la toma tiene que estar clavada, porque todo el movimiento lo va a poner el modelo después.
Graba en la resolución más alta que te deje. La salida baja a 720p, pero el modelo trabaja mejor con detalle de sobra.
Una lámpara visible en cuadro
En el video de ejemplo hay un flash de estudio sobre un trípode, a cuadro izquierdo. Ésa es la fuente que el prompt enciende, apaga y mueve.
Sin una fuente visible, los cambios de luz se ven a render: aparecen de la nada y el ojo lo detecta. Una lámpara de piso sirve.
Espacio detrás y a los lados
El plano se va a abrir más allá de tu encuadre original. Lo que haya detrás lo va a extender el modelo, y entre más limpio, mejor le sale.
Una esquina con dos paredes y algo de profundidad es ideal. Un fondo pegado a tu espalda mata la mitad de los movimientos.
Parte 02 · el dinero
Lo que cuesta una tirada, con la cuenta hecha
Los precios cambian según dónde lo corras. El más transparente, porque publica la fórmula, es fal.ai; sirve de referencia aunque tú lo corras en otro lado.
El precio base
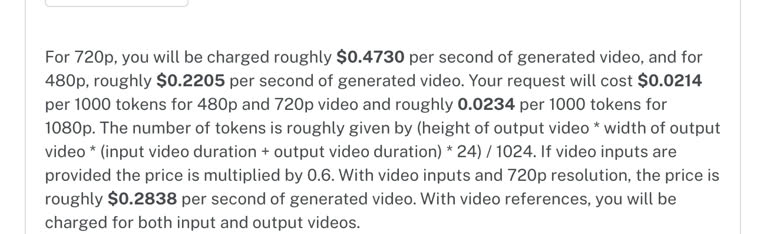
$0.4730 por segundo generado a 720p. $0.2205 a 480p. Si le entras un video de referencia, el precio se multiplica por 0.6: a 720p queda en $0.2838 por segundo.
Pero se cobran los dos videos
Textual de su página: «con referencias de video se te cobra tanto el video de entrada como el de salida». Editar 28 segundos no cuesta 28 segundos: cuesta 56.
La cuenta del video de ejemplo
28.2 s de entrada + 28.2 s de salida = 56.4 s × $0.2838 = $16.00 a 720p. A 480p la misma tirada sale en $7. Y sale igual si el resultado te gusta que si no.
La cuenta que importa no es la de una tirada
Es la de cuántas tiradas hasta que quede. Un prompt escrito a lo bruto —«hazlo cinematográfico, con movimientos de cámara»— se va a cuatro o cinco intentos y ninguno se parece al anterior, porque no le diste nada estable a lo que agarrarse. Un prompt escrito como el de esta guía sale en una o dos. Ahí está el ahorro real, y por eso el resto del documento es sobre cómo se escribe, no sobre qué botón apretar.
Si lo corres en Higgsfield se paga con los créditos de tu plan y no con dinero por segundo, así que el número de arriba no aplica tal cual; sirve como referencia de mercado. La fórmula completa de tokens que publica fal es: (alto × ancho × (duración de entrada + duración de salida) × 24) / 1024, a $0.0214 por cada 1000 tokens en 480p y 720p.
Parte 03 · el camino
Cómo se ve de principio a fin
Cinco pasos. El tercero es donde se gana o se pierde, y es al que esta guía le dedica la mitad de las páginas.
Grabas la toma, quieto
Celular en tripié, tú sentado, sin moverte. Hablas tu guion de corrido y no cortas al terminar: la cola sirve.
10 minutos · una toma buena y dos de respaldoSacas los tiempos de lo que dijiste
Necesitas saber en qué segundo empieza y termina cada frase. Sin eso no puedes escribir el prompt, porque el prompt va pegado a las frases.
5 minutosEscribes el prompt por bloques
Un bloque por frase, cada uno con su marca de tiempo, su frase literal y la dirección de cámara que le toca. Más cuatro párrafos de reglas arriba.
30 a 45 minutos la primera vez · 10 las siguientesLo generas en modo edición de video
Subes tu toma como referencia de video, pegas el prompt y apagas el audio. La voz buena es la tuya, no la que invente el modelo.
3 a 8 minutos de espera por tiradaLo montas
Solo, o a doble pantalla con tu toma original debajo. El formato de comparación está en la Parte 09.
20 minutosÍndice
Lo que sigue
Las tres partes de arriba son la decisión, el dinero y el camino. Las que siguen son la ejecución. Si ya sabes de qué va, la Parte 06 es el prompt completo y la 07 el catálogo para armar el tuyo.
- 01Qué necesitas antes de escribir una líneaCelular, tripié, una lámpara visible y espacio detrás
- 02Lo que cuesta una tiradaLa fórmula publicada, y por qué se cobran los dos videos
- 03Cómo se ve de principio a finLos cinco pasos con su tiempo real
- 04La toma base: siete reglasLo que se decide antes de grabar y ya no se arregla
- 05La anatomía del promptLas cuatro capas, con el texto literal de cada una
- 06El prompt completo, bloque por bloqueCon el cuadro que produjo cada bloque
- 07Catálogo de movimientosDoce líneas listas para pegar en tu propio prompt
- 08Los cinco errores que se paganEmpezando por el que te cobra una tirada completa
- 09Cómo se monta el antes/despuésEl formato de doble pantalla, con sus números
- 10Cuándo esto no es para tiTres casos en los que no vale la pena
- 11Fuentes y métodoQué se verificó, dónde y cuándo
Parte 04 · la materia prima
La toma base: siete reglas
Todo lo que sale mal aquí se paga después en tiradas. Ninguna de las siete cuesta dinero.
1 · Clavado, de verdad
Tripié y no lo toques. Ni reencuadres, ni te acerques, ni ajustes a media toma. Todo el movimiento lo pone el modelo, y si tú también te mueves, los dos movimientos se pelean y se nota.
2 · Una mano libre
Si sostienes un micrófono, sostenlo siempre con la misma mano y deja la otra libre. La mano libre es la que va a hacer los gestos que el prompt le pida —en el video de ejemplo, sacar al camarógrafo del cuadro—.
3 · Luz plana al grabar
Toda la dramaturgia de luz se agrega después. Si tu toma ya trae una sombra dura, se pelea con la que el prompt va a crear. Luz pareja y aburrida es la mejor base.
4 · Nada de gorra
Los sombreros y las gorras son donde primero se rompe la identidad cuando el modelo reencuadra. Si puedes evitarlos, evítalos.
5 · Aire arriba de tu cabeza
Los títulos en 3D viven detrás y arriba de ti. Si tu cabeza está pegada al borde superior, no hay dónde ponerlos y el modelo los mete encima de tu cara.
6 · No cortes al terminar
Sigue grabando dos o tres segundos más y di ahí tu llamado a la acción. Esa cola no entra a la generación —se recorta antes—, pero es la que después aterriza el cierre del montaje con tu voz real.
7 · Habla de corrido
El prompt se arma por frases. Si haces pausas largas y erráticas, los bloques quedan desiguales y algunos duran menos de un segundo. Un ritmo parejo produce bloques parejos.
Parte 05 · la estructura
La anatomía del prompt: cuatro capas
Antes del primer bloque de tiempo van cuatro párrafos. Ninguno es relleno: cada uno tapa una forma distinta en la que el resultado se rompe. Están en inglés a propósito — es el idioma en el que estos modelos están mejor entrenados, y tu guion en español dentro de los bloques funciona igual.
Capa 1 · preservación
Le dices qué no se toca. El silencio se interpreta como permiso, así que todo lo que quieras intacto tiene que estar nombrado.
Preserve the same room, chair, microphone, clothing, hair, body proportions, facial identity, skin texture, hand gestures, eyeline, lip movement, speech timing and acting. He wears no cap and no hat, and holds a small handheld microphone in his right hand the whole time; his left hand stays free. The main character's face must remain identical in every frame. Do not beautify, reshape, replace or reinterpret him. Keep every spoken word unchanged with accurate lip sync.«Do not beautify» no sobra. Sin esa palabra el modelo te suaviza la piel y te cambia la cara lo suficiente para que se note entre bloque y bloque.
Capa 2 · el cuarto
Describes tu espacio real, objeto por objeto. Esto es lo que le permite extender el cuarto cuando la cámara se abre, en vez de inventar una habitación distinta cada vez.
The room is a bright apartment: a white wall behind him, a black studio strobe on a light stand at frame left, a black desk at frame left holding a monitor and a snake plant, a large macrame wall hanging directly behind his head, and an open kitchen at frame right with dark wood cabinets, a stone counter, a stainless range hood and a black bar stool, over white tile floor. Every lighting change must be motivated by a fixture that exists in this room.Cambia el inventario por el de tu cuarto. La frase que no se cambia es la última: es la que evita que la luz cambie de la nada.
Capa 3 · continuidad
Le prohíbes lo que un modelo de video hace por defecto: cortar, teleportar, duplicarte, meter objetos.
Make it one continuous, dynamic music-video-style take inside the same room. No cuts, scene changes, teleporting, duplicate characters or random objects. Every virtual camera move must connect smoothly with believable perspective, parallax, motion blur and room geometry. Keep the character anchored to his original performance. Do not distort or cover his face. Use polished kinetic supers timed to key phrases, appearing beside or behind him with realistic depth and clean dissolves. Do not subtitle the spoken words - the only on-screen text is the supers listed below, exactly as written.La última frase es la que evita que te ponga subtítulos automáticos encima de todo. Si no la pones, los pone.
Capa 4 · el look
La que convierte «movimiento de cámara» en «cine». Sin ella los movimientos son correctos y la imagen se ve a videojuego.
Cinematic grade and texture throughout: shallow depth of field with creamy falloff, anamorphic-style oval bokeh, subtle horizontal blue lens flares off every hard light, volumetric haze catching the beams, fine film grain, and natural motion blur on every camera move. Rich contrast, deep slightly cool blacks, warm true skin. Never posterize his face or shift his skin tone.Parte 06 · el corazón
El prompt completo, bloque por bloque
Éste es el prompt que produjo el video, entero. Cada bloque lleva su marca de tiempo, la frase que se dice en ese tramo y la dirección de cámara. Ése es el truco entero: el modelo sabe qué está pasando en el audio mientras cambia el ángulo, y por eso no se le desincroniza la boca.
Cómo se adapta a tu video. Cambia las frases por las tuyas y sus tiempos por los tuyos; la dirección de cámara de cada bloque la puedes dejar casi igual, o armarla desde el catálogo de la Parte 07. Lo que no se cambia es el formato: inicio-fin, "frase literal" y después el párrafo de dirección.
Create a 28.2-second Seedance 2.5 video-to-video transformation using the uploaded footage as the exact performance reference.

Preserve the same room, chair, microphone, clothing, hair, body proportions, facial identity, skin texture, hand gestures, eyeline, lip movement, speech timing and acting. He wears no cap and no hat, a dark navy open overshirt over a cream t-shirt, and holds a small handheld microphone in his right hand the whole time; his left hand stays free. The main character's face must remain identical in every frame. Do not beautify, reshape, replace or reinterpret him. Keep every spoken word unchanged with accurate lip sync.

The room is a bright apartment: a white wall behind him, a black studio strobe on a light stand at frame left, a black desk at frame left holding a monitor and a snake plant, a large black macrame wall hanging directly behind his head, and an open kitchen at frame right with dark wood cabinets, a stone counter, a stainless range hood and a black bar stool, over white tile floor. Every lighting change must be motivated by a fixture that exists in this room - above all the studio strobe at frame left, which is the key light for every dramatic look.

Make it one continuous, dynamic music-video-style take inside the same room. No cuts, scene changes, teleporting, duplicate characters or random objects. Every virtual camera move must connect smoothly with believable perspective, parallax, motion blur and room geometry. Keep the character anchored to his original performance. Do not distort or cover his face. Use polished kinetic supers timed to key phrases, appearing beside or behind him with realistic depth and clean dissolves. Do not subtitle the spoken words - the only on-screen text is the supers listed below, exactly as written. Compose every beat so the character and all supers stay inside the central 9:16 region of the 16:9 frame.

Cinematic grade and texture throughout: shallow depth of field with creamy falloff, anamorphic-style oval bokeh, subtle horizontal blue lens flares off every hard light, volumetric haze catching the beams, fine film grain, and natural motion blur on every camera move. Rich contrast, deep slightly cool blacks, warm true skin. Never posterize his face or shift his skin tone.

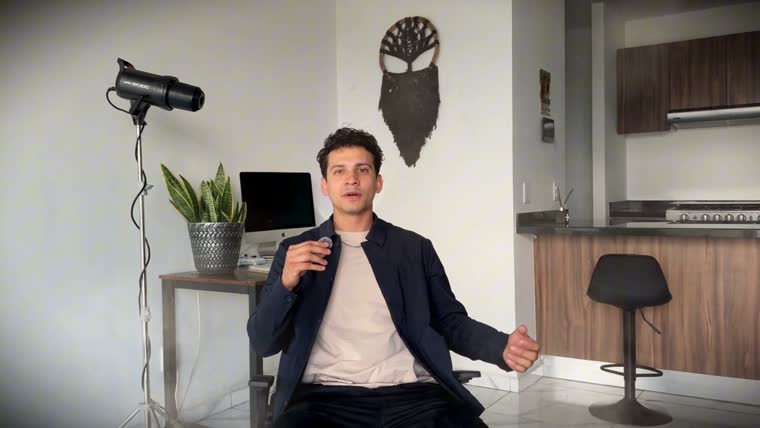
0-2.2s, "Bienvenido al 2026,"
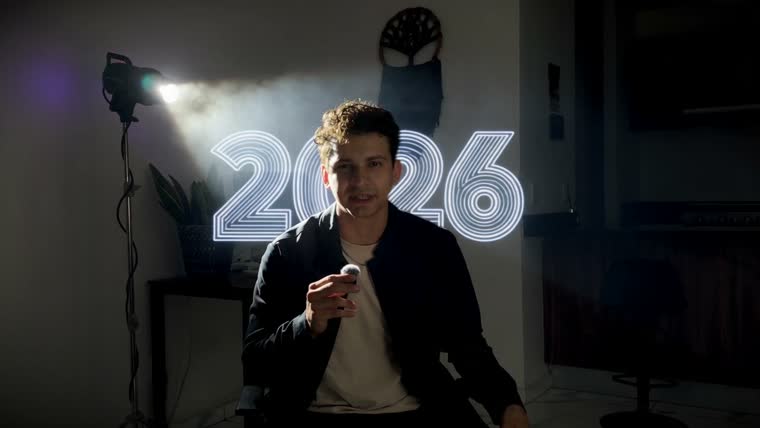
Start from the original framing. The daylight and the room lights power off in a fast ripple from frame right to frame left; the studio strobe at frame left fires once with a bright pop and stays on as a hard key, throwing a long sharp shadow of him across the white wall, with a thin rim light on his hair and shoulders and volumetric haze in the beam. Add a slight floating camera push. Large 3D text "2026" forms in real space behind him, edge-lit by the strobe and partially hidden by his head and shoulders, then fades. Preserve enough facial detail to maintain identity.

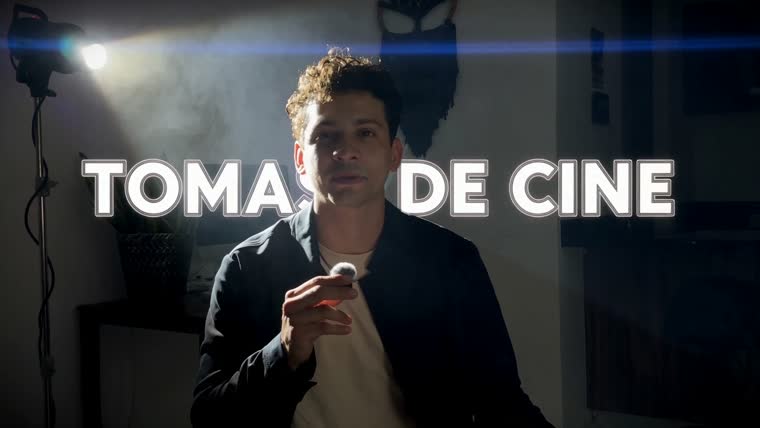
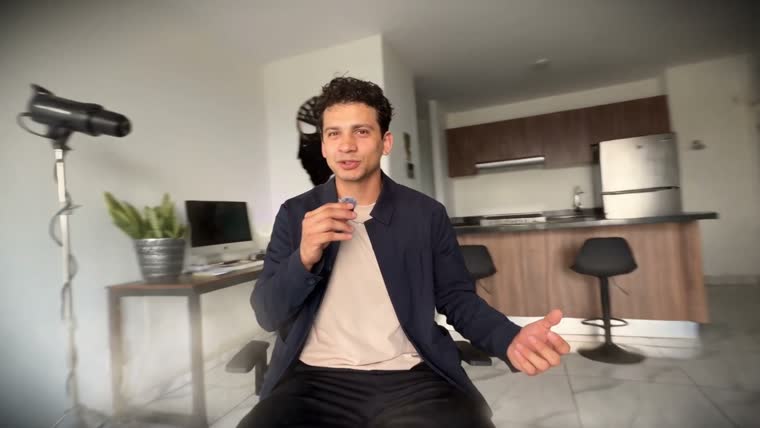
2.2-6.2s, "ya no es necesario un videografo para obtener tomas cinematograficas como esta."
Perform a true dolly zoom: physically push the camera toward him while the room stretches and the back wall pulls away behind him, keeping his head the same size in frame. As the move peaks, one wide horizontal blue anamorphic flare streaks across the frame. Land on a chest-up close-up with shallow depth of field and his face sharp and unchanged. Never crop digitally. "TOMAS DE CINE" appears beside him with dimensional depth and dissolves.

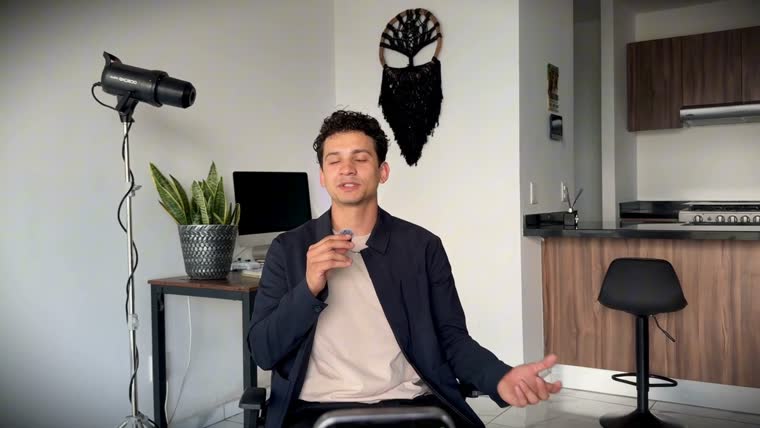
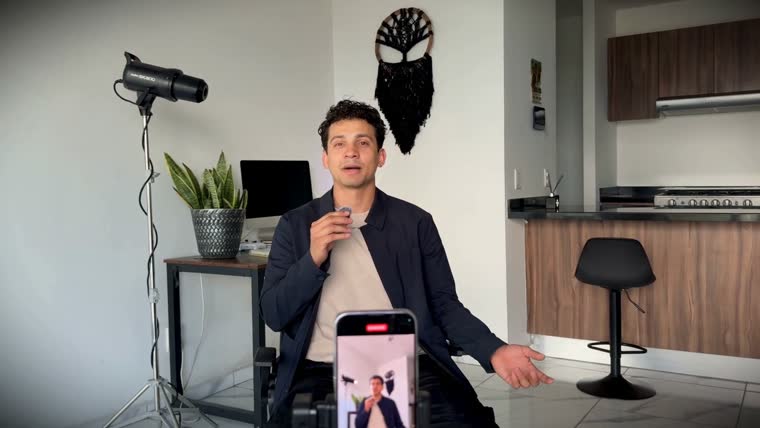
6.2-9.6s, "Actualmente la IA nos da resultados increibles,"
Natural daylight floods back as the room lights power on one by one. Pull rapidly backward beyond the original framing and extend the same room naturally, revealing a smartphone on a tripod in the foreground recording him, with the desk and the kitchen in correct perspective. Correct perspective must show this was a locked static setup. Do not duplicate the character.

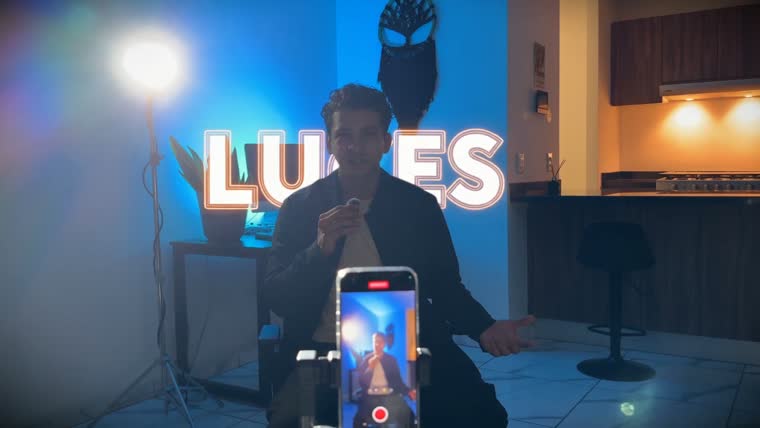
9.6-11.0s, "moviendo luces,"
On the word "luces" the studio strobe at frame left swings and arcs around him on its stand while its beam sweeps across his face; a cold blue backlight ignites behind the macrame and a warm practical glows from the kitchen, relighting the whole room inside one continuous move - teal shadows against warm skin. The camera drops low toward desk height as the light travels. "LUCES" appears with visible light spill and dissolves fast.

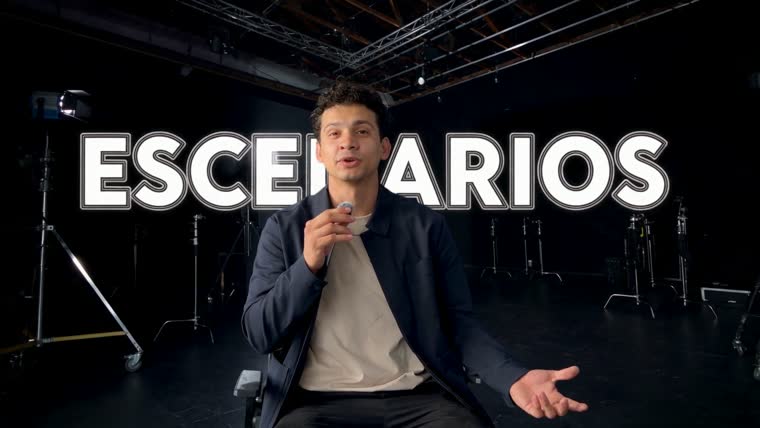
11.0-12.3s, "escenarios,"
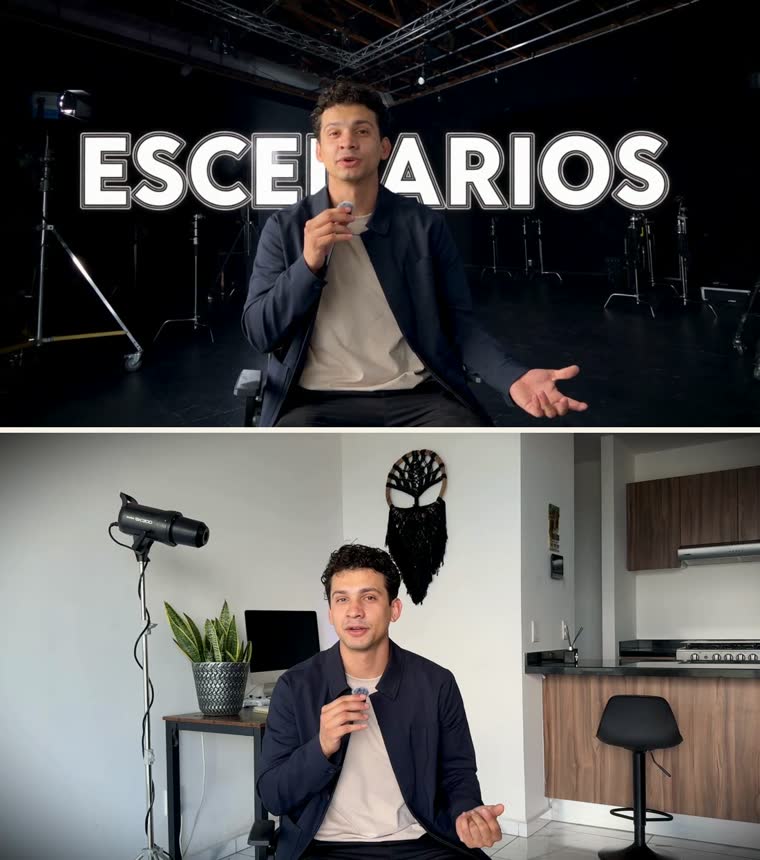
The apartment walls peel outward like flats on a soundstage, revealing for a moment a black studio void with C-stands, rigging and a lighting grid overhead, while he stays seated and lit exactly the same. The camera whips to a low three-quarter hero angle. "ESCENARIOS" stands huge behind him in real space, correctly occluded by his body.

12.3-14.9s, "regresandonos a lo anterior,"
Time visibly reverses: the flats fly back into place, the studio grid retracts, the daylight returns and the strobe swings back to its original position, all in one smooth continuous rewind with trailing motion blur. The camera glides back toward the original frontal position. "REGRESA" trails backwards across the frame and dissolves.

14.9-17.0s, "con camaras cambiando de angulo,"
Three fast whip-blurred repositions inside one unbroken move: a low hero angle from floor level, then a hard side profile at eye level, then a high three-quarter from above the kitchen counter. Each landing snaps to a crisp hold with a brief flare. The whips connect the angles - there are no cuts. Keep his performance and lip sync exact from every perspective.

17.0-20.4s, "girandonos a nuestro alrededor."
Accelerate into one complete 360-degree indoor drone orbit around him, lower and faster than a normal orbit, passing behind the chair and skimming the desk. At the midpoint the room freezes into bullet time - dust motes and the macrame fringe hang suspended in the air - while he keeps speaking and the camera keeps traveling; as the orbit completes, time resumes and the camera lands precisely at the original frontal position. Keep him fixed in the chair and the room consistent, with believable motion blur and near-object parallax. No cloning, room mutation or lip-sync interruption.

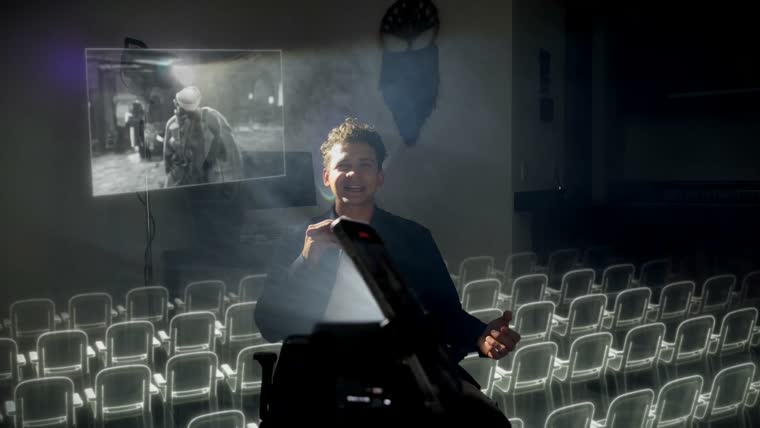
20.4-24.9s, "Te lo juro, la IA se ha vuelto casi casi un cine de bolsillo."
The room darkens again. The smartphone in the foreground turns and throws a real projector beam through the haze onto the white wall behind him, forming a small glowing cinema screen that plays a silent montage of the camera moves already seen. Rows of tiny theatre seats draw themselves in light across the tile floor. The camera cranes up and over his shoulder so both he and the projected screen are in frame, then eases back down. "CINE DE BOLSILLO" burns in as 3D letters lit by the projector beam, then dissolves.

24.9-28.2s, "Nunca mas vas a tener que contratar a un camarografo."
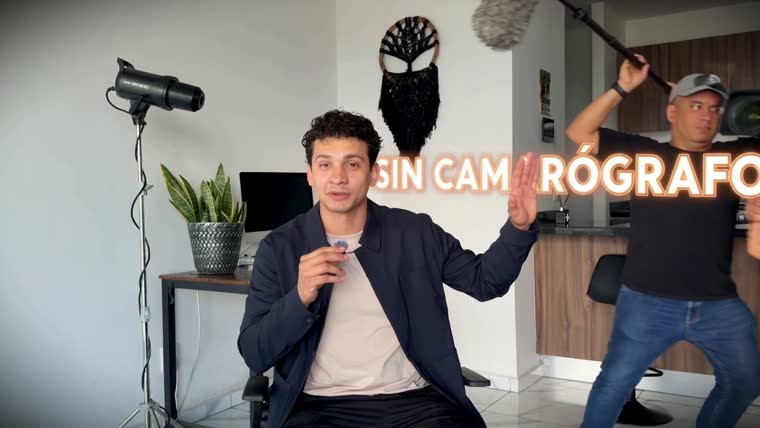
Full daylight returns. A cameraman enters naturally from the right side carrying a shoulder camera rig, followed by a boom operator. Without stopping his speech or changing his eyeline, the main character firmly but playfully pushes and signals them out with his free left hand. They react and exit; as they leave frame they dissolve into drifting particles of light. "SIN CAMAROGRAFO" appears behind them, then disappears. The camera settles back to the exact original framing and ends locked, the way it began.
Y esto es lo que produjo cada bloque
Cuadros del video real, en el segundo que indica cada pie. Ninguno está retocado.
Parte 07 · las piezas
Catálogo de movimientos
Doce direcciones que funcionan, cada una con la línea lista para pegar dentro de un bloque. Combina una o dos por bloque — nunca tres.
1. DOLLY ZOOM
Perform a true dolly zoom: physically push the camera toward him while the room
stretches and the back wall pulls away behind him, keeping his head the same size
in frame.

2. PUSH-IN FISICO
Accelerate smoothly into a tight face close-up using a physical camera push, not a
digital crop. Keep his face sharp and unchanged.

3. RETROCESO QUE ABRE EL CUARTO
Pull rapidly backward beyond the original framing and extend the same room
naturally, revealing the floor and the far wall in correct perspective. Do not
duplicate the character.

4. ARCO BAJO A PERFIL
Lower the virtual camera toward desk height and arc smoothly to one side, ending
on a strong side-profile angle. Keep his performance and lip sync exact from the
new perspective.

5. GRUA A PICADO
The camera cranes vertically upward into a high top-down angle while he continues
speaking and looks naturally toward the moving camera. Preserve the room layout
and avoid ceiling or body warping.

6. GIMBAL SUAVE
Descend to eye level and perform a clean gimbal move: smooth push toward him, ease
backward, then settle. No jerky digital zoom.

7. TRES ANGULOS CON WHIP
Three fast whip-blurred repositions inside one unbroken move: a low hero angle
from floor level, then a hard side profile at eye level, then a high three-quarter.
Each landing snaps to a crisp hold. The whips connect the angles - there are no cuts.

8. ORBITA DE DRON 360
Accelerate into one complete 360-degree indoor drone orbit around him. Keep him
fixed in the chair and the room consistent, with believable motion blur and
near-object parallax, then land precisely at the original frontal position.

9. BULLET TIME
At the midpoint the room freezes into bullet time - dust motes hang suspended in
the air - while he keeps speaking and the camera keeps traveling; then time
resumes.

10. TITULO 3D EN ESPACIO REAL
Large 3D text "TU PALABRA" forms in real space behind him, correctly occluded
where his body overlaps it, casting subtle light and shadow, then dissolves.

11. CAMBIO DE LUZ MOTIVADO
The room lights power off in a fast ripple; the lamp at frame left switches on as
a hard key, throwing a long sharp shadow across the wall, with a thin rim light on
his hair and volumetric haze in the beam.

12. INTERFAZ QUE TECLEA SOLA
A translucent holographic interface appears beside him. "TU COMANDO" types itself
into the interface, glows, then dissolves as the command activates.
Una acción por bloque. El catálogo tienta a encadenar cuatro movimientos en un bloque de tres segundos. No lo hagas: el modelo reparte el tiempo entre todos y ninguno se completa. Un bloque, un movimiento, y como mucho un cambio de luz encima.
Parte 08 · los tropiezos
Los cinco errores que se pagan
En orden de cuánto cuesta descubrirlos.
1 · Dejar el audio encendido
El parámetro generate_audio viene en true por defecto en todas las plataformas. Si lo dejas así, el modelo te inventa una voz encima de la tuya y pagas la tirada completa para enterarte. Apágalo siempre: la voz buena ya está en tu toma. En el video de ejemplo, la voz que se oye durante los primeros 28 segundos salió del archivo que devolvió Seedance porque conservó la pista original, y el llamado a la acción del final salió de la cola del crudo.
2 · Volver a describir la cara en cada bloque
La identidad ya la fijaste en la capa de preservación. Si en el bloque 6 vuelves a escribir «un hombre de pelo rizado con camisa azul», el modelo lo trata como una instrucción nueva y te la reinterpreta. En los bloques se describe la escena y la cámara, nunca a la persona.
3 · Meter dos acciones en un bloque
«Se levanta y camina hacia la ventana mientras la luz cambia» en un bloque de tres segundos produce las tres cosas a medias. Un verbo por bloque. Si necesitas dos, parte la frase en dos bloques.
4 · Cambiar la luz sin una fuente que la explique
Es el error que más se nota y menos se identifica. El movimiento sale bien pero «se ve raro». La causa es que la luz cambió de golpe sin venir de ningún lado. La línea every lighting change must be motivated by a fixture that exists in this room arregla la mitad de los casos; tener una lámpara real en cuadro arregla la otra mitad.
5 · Pedir cortes en una toma que dijiste continua
Si le pides «corta a un plano cerrado» dentro de un prompt que arriba declaró no cuts, se contradice y resuelve como puede: normalmente teleportándote. Los cambios de ángulo dentro de una toma continua se piden como whip, arco o salto de cámara —movimientos que conectan—, nunca como corte.
Parte 09 · el montaje
Cómo se monta el antes/después
El resultado solo ya funciona, pero la comparación es lo que hace que la gente se detenga: sin la toma original debajo, nadie sabe que el mérito es del prompt.
Los dos videos arrancan en el cuadro cero
Nada de desfases ni de recortar el arranque de uno para «cuadrarlo». Los dos empiezan exactamente al mismo tiempo; ver el mismo gesto en los dos cuadros es lo que prueba que es la misma toma.
El de IA termina antes, y ahí cambia el cuadro
Lo que se generó dura menos que el crudo, porque el crudo trae la cola con tu llamado a la acción. Cuando el de arriba se acaba, se apaga y el original sube al centro y sigue solo. Ahí aterriza el llamado a la acción, con tu voz real diciéndolo.
Una sola pista de voz
Los dos archivos traen audio y no se pueden reproducir juntos: se duplica la voz y se oye a cañón. Se usa la del video generado para el cuerpo y la del crudo para la cola, y se nivelan las dos al mismo volumen. Un salto de nivel a mitad de un video corto se siente como un error de grabación.
Números del montaje de ejemplo, por si sirven de referencia: la narración cierra en el segundo 27.6, el cuadro de arriba se apaga ahí mismo, el de abajo sube en el 28.3 —justo cuando la voz vuelve— y la tarjeta del llamado a la acción entra en el 28.9, en la respiración entre dos frases. Todo medido sobre la onda, no a ojo.
Parte 10 · el filtro
Cuándo esto no es para ti
Adelante si…
- Ya grabas hablando a cámara y quieres que se vea producido sin contratar a nadie.
- Te acomoda escribir con detalle. El prompt de arriba tiene 700 palabras y ése es el trabajo.
- Puedes gastar entre $7 y $32 en las dos o tres tiradas que te va a tomar la primera vez.
- Tienes un cuarto con algo de profundidad y una lámpara visible.
Todavía no, si…
- Quieres que la IA te invente un video desde cero. Esto edita una toma tuya; para inventar hay otros modos y otro precio.
- Tu video son capturas de pantalla o material que no eres tú hablando. Este camino vive del rostro y la sincronía labial.
- Necesitas que el resultado sea idéntico dos veces. No lo es: cada tirada cambia en los detalles.
- Grabas en movimiento o con la cámara en la mano. Sin toma clavada, nada de esto aplica.
Parte 11
Fuentes y método
- Precios de Seedance 2.5 — el precio por segundo, el multiplicador de 0.6 con video de referencia, la fórmula de tokens y la frase sobre que se cobran los dos videos, leídos y capturados de su página de modelo. fal.ai/models/bytedance/seedance-2.5/reference-to-video · consultado el 20 ago 2026
- Parámetros del modelo — los modos t2v, omni_reference, video_edit y video_extension, el rango de 4 a 30 segundos, las resoluciones 480p/720p/1080p y el valor por defecto de generate_audio, leídos de la ficha del modelo en la API de Higgsfield. · consultado el 20 ago 2026
- Duración y edición de video — la generación nativa de 30 segundos en una pasada y la posibilidad de dar un video de referencia para describir cambios, de la ficha del modelo en Replicate. replicate.com/bytedance/seedance-2.5 · consultado el 20 ago 2026
- El prompt, los cuadros y los tiempos — son de nuestra propia producción del 20 de agosto de 2026. Los cuadros salen del archivo que devolvió el modelo, sin retoque; los tiempos de cada frase se midieron sobre la onda del audio y se verificaron transcribiendo cada tramo por separado.
Método. Las cifras de precio se leyeron en la página del proveedor y se capturaron ahí mismo, no de un resumen. Los parámetros del modelo salen de la ficha que devuelve la API, no de un artículo. Los diez cuadros de la Parte 06 son fotogramas literales del video generado. Sotai no está afiliada a ByteDance, a fal.ai, a Higgsfield ni a Replicate.
¿Y si esto no fuera un video suelto, sino todo lo que publicas?
Una cosa más
Con esta guía sacas el video por tu cuenta, y ése era el trato. Pero hay un punto en el que deja de ser un tema de prompts: cuando ya no es un video sino veinte al mes, cuando alguien tiene que medir cuál funcionó, y cuando lo que sigue después del video —el que comenta, el que pregunta, el que compra— también tiene que pasar solo. Eso es lo que armamos en Sotai. Si vas para allá, escríbenos por DM y lo vemos.
Volver al promptGuía preparada por Sotai · 20 de agosto de 2026 · No estamos afiliados a ByteDance, fal.ai, Higgsfield ni Replicate.
Sigue aprendiendo
Más guías de video e imagen
 Video en vivo · 12 sep 2026Una transmisión que nunca termina y que el público dirige
 GPT Image · 22 ago 2026100 comandos para transformar cualquier foto con IA
 Seedance 2.5 · 17 ago 2026Videos de producto con IA
¿Lo quieres funcionando en tu negocio sin armarlo tú?
Escríbenos